表現を操る演技ディレクション術
Gemini 3.8 TTS を使いこなす最大の鍵は、「誰が話すか(Cast)」「どう演じるか(Direct)」「何を喋るか(Speech)」を混ぜずに3つのレイヤーに分離することです。この章では、声優に演技指導をするように声を自在にコントロールする全テクニックを、実際の生成音声とともにマスターします。
1. 最重要コンセプト:3レイヤー分離アーキテクチャ
前世代(Gemini 3.1 TTS など)では、自然言語プロンプトの中に「落ち着いた声で『こんにちは』と読んで」と指示もセリフも一緒に書いていました。しかしこの方法には、「ト書き(演技指示)まで間違えて声に出して読んでしまう」「長い文章の途中でキャラクター設定を忘れて声が変わってしまう」という弱点がありました。
Gemini 3.8 TTS(Interactions API)では、この問題を根本から解決するため、API のフィールド自体が 3つの独立したレイヤー に分かれています。
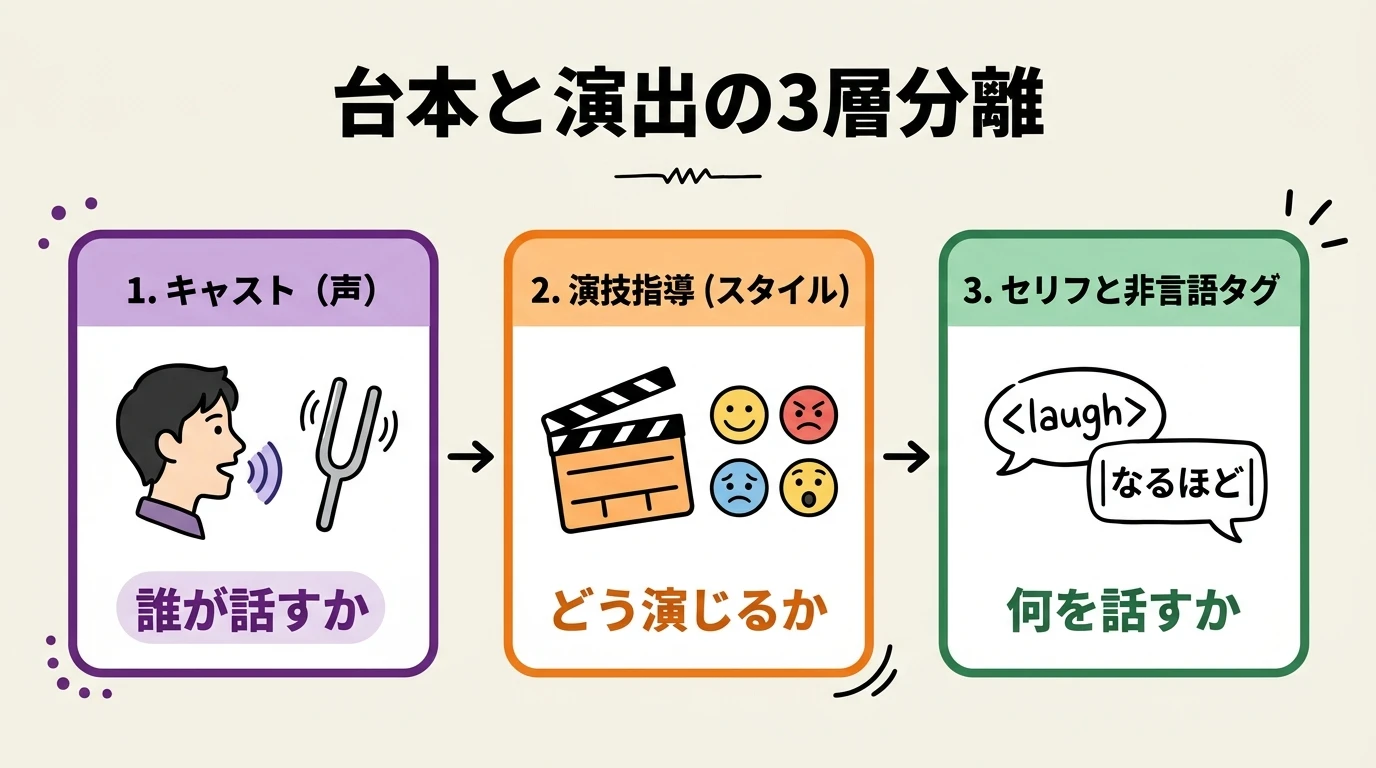
| レイヤー | API フィールド | ここに書くべきこと(役割) | ここに書いてはいけないこと(NG例) |
|---|---|---|---|
| 第1層:Cast (誰が話すか) | generation_config.speech_config.voiceまたは Voice Design の prompt | 不変のキャラクター属性 標準ボイス名( Kore 等)、カスタム音声 ID(voice_...)。Voice Design 時は年齢・性別・声質・アクセントなど「その人固有の変わらぬ特徴」。 | 「怒って」「早口で」など、シーンごとに変わる一時的な感情(※Voice Design に入れると全セリフが怒り声に固定されてしまいます) |
| 第2層:Direct (どう演じるか) | speech_metadata.style | そのターンの感情・ペース・空気感 例: "whispering urgently, fast pace"、"warm, empathetic concierge"。英語・日本語どちらでも指定可能。 | 実際に読み上げてほしいセリフ本文、または「30代女性」など第1層と矛盾する別人の声質指定 |
| 第3層:Speech (何を言うか) | input[].content[].text | 一字一句そのまま発声する台本 セリフ本文 + インラインタグ( <sigh> 等) + パイプ相づち(|うんうん|) + IPA発音指定。 | (悲しそうに) や [ここで笑う] といった独自の日本語ト書き(※そのまま文字通り読み上げられてしまいます) |
2. 実験:同じ声・同じセリフで「Direct(style)」だけを変えるとどうなる?
第2層(speech_metadata.style)の威力を体感してみましょう。以下の4つのサンプルは、すべて同じボイス(Algenib)かつ一字一句同じ日本語テキスト 「まさか、本当にこの計画が通るとは思っていませんでした。」 ですが、style の指定だけを変えています。
1. Baseline(style 指定なし・空欄)
style を空にした状態。文脈と句読点だけで自然な標準トーンで読み上げます
たった今、例の封筒を開けたんだが……中に入っていたものを見たら、君もきっと信じられないはずだ。
2. Ecstatic(歓喜・興奮)
同じ声(Algenib)のまま、ピッチとエネルギーが跳ね上がり喜びが溢れ出します
<gasp> たった今、例の封筒を開けたんだが! <laugh> 中に入っていたものを見たら、君もきっと信じられないはずだ!
3. Panicked Whisper(緊迫した早口の囁き)
周囲を警戒するような切迫したウィスパーボイスと速いテンポに変化します
<breath> たった今、例の封筒を開けたんだが…… <short pause> 中に入っていたものを見たら、君もきっと信じられないはずだ……!
4. Defeated(落胆・無気力)
深いため息とともに、力が抜けきった重いトーンで語られます
<sigh> たった今、例の封筒を開けたんだが…… <long pause> 中に入っていたものを見たら、君もきっと信じられないはずだ。
プロのコツ:句読点も「演技の楽譜」になる
style だけでなく、テキスト内の記号もイントネーションに影響します。感嘆符(!)は声のエネルギーとピッチを引き上げ、三点リーダー(……)はためらいや余韻を生み、疑問符(?)は語尾のピッチを自然に持ち上げます。
3. 非言語表現と「間」を刻むインラインタグ(全24種リファレンス)
人間が話すとき、言葉の合間には必ず「息継ぎ」「咳払い」「クスクス笑い」「ため息」などの非言語音(パラ言語表現)が入ります。Gemini 3.8 TTS では、セリフの好きな位置に山括弧のタグ(例:<sigh>)を埋め込むだけで、声質を保ったまま自然なアクションを演じます。
鉄則:日本語のセリフ内でも、インラインタグは必ず「英語の公式タグ名」で書く!
日本語の台本だからといって <ため息> や <笑う> と書くと、タグとして認識されず「ためいき」と読み上げられてしまう場合があります。必ず以下の公式英語タグ(<sigh>、<chuckle> など)を使用してください。
インラインタグ実演:笑いをこらえるニュースキャスター
<throat-clearing>(咳払い)、<snicker>(忍び笑い)、<chuckle>(吹き出し笑い)を単語の合間に配置した人間味あふれる演技
続いて地域の話題です。今年コンテストで優勝した巨大なブタの名前が正式に発表され…… <throat-clearing> 失礼しました、<snicker> 名前は「クリス・P・ベーコン」…… <chuckle> ぷっ、失礼いたしました、お天気コーナーへ移ります。
| カテゴリ | タグ記法 | 意味・アクション | 効果的な使いどころ |
|---|---|---|---|
| 呼吸・息遣い | <breath> | 自然な息継ぎ | 長い文の区切りや、話し始める直前に置くと人間らしさが一気に増す |
<heavy breath> | 深い息・荒い呼吸 | 緊張している場面や、重大な告白の前に効果的 | |
<exhales> | 息を吐き出す | 安堵した瞬間や、肩の力を抜くセリフの直前に配置 | |
<pant> | ハァハァと息を切らす | 走ってきた直後やパニック状態の演出に | |
<sigh> | ため息 | 疲労・呆れ・深い共感(「わかります…」の前など)に万能 | |
| 笑い・微笑み | <laugh> | 声に出して笑う | 明るい会話や、冗談を言った直後に挿入 |
<chuckle> | クスクス・ふふっと笑う | ニュースや解説番組で少しユーモアを交えるときに最も自然 | |
<giggle> | 無邪気にクスクス笑う | 親しみやすいキャラクターや楽しい雑談シーン向け | |
<snicker> | 忍び笑い・ニヤリと笑う | いたずらっぽいセリフや皮肉を込めた演技に | |
<cackle> | 高笑い・哄笑 | ファンタジーの悪役やテンションが振り切れた場面に | |
| 感情・声のリアクション | <gasp> | ハッと息を呑む | サプライズ発表や衝撃の事実に気づいた瞬間の冒頭に |
<sob> | すすり泣く | 悲しみをこらえながら話すドラマチックな場面に | |
<cry> | 泣き声 | 感情が溢れ出すクライマックスのセリフに | |
<whimper> | 弱々しく鳴く・怯え声 | ホラーや心細いシチュエーションの演出に | |
<groan> | うめき声・うなり声 | 頭を抱えるような失敗談や苦渋の決断の前に | |
| 生理現象・ニュアンス音 | <throat-clearing> | 咳払い(コホン) | 本題に入る前や、気まずい空気を変えるスイッチとして抜群 |
<cough> | 咳き込む | 体調不良の演技や、言葉を濁すシーンに | |
<sneeze> | くしゃみ | 日常感のあるコメディやラジオドラマのアクセントに | |
<snort> | 鼻を鳴らす(フンッ) | 呆れたときや、吹き出し笑いの直前に | |
<yawn> | あくび | 深夜ラジオ風のトークや、眠そうなキャラクターの演出に | |
<tsk> | 舌打ち(チッ) | 苛立ちや「やれやれ」というニュアンスを短く表現 | |
<argh> | 「あーっ!」という唸り | 悔しがる瞬間やもどかしさの表現に | |
| 間(ポーズ)の制御 | <short pause> | 短い間(約0.3〜0.5秒) | 句読点だけでは足りない「溜め」や、話題の切り替えに |
<long pause> | 長い間(約1秒前後) | クイズの正解発表前や、深い余韻を残したい文末・文中に |
4. マルチパートターン:1つのセリフの途中で演技トーンを切り替える
「最初は普通に案内していたのに、途中から急に小声でヒソヒソ話になる」といった演出をしたいとき、音声を2回に分けて生成して結合すると、つなぎ目で声のトーンや空間の響きが不自然に途切れてしまいます。
そこで使うのが マルチパートターン(Multi-part turns) です。1つの turn の content 配列に複数のテキストブロックを並べ、ブロックごとに別々の speech_metadata.style を指定すると、1回の連続した音声として滑らかに演技が変化します。
Multi-part ターン転換:静寂の観察からパニック、安堵まで
1回のAPI呼び出し内で content 配列を3つのパートに分け、パートごとに異なる style を付与して急激な場面転換を実現
[Part 1] 絶対に動かないでください…… <breath> ライオンまであと2メートルです…… [Part 2] <gasp> こっちへ走ってきた! <argh> 車に乗って!! [Part 3] <pant> ふぅ……車の中から安全に観察すると、<throat-clearing> 大自然の迫力がよくわかりますね。
# マルチパートターンのリクエスト構造(Interactions API)
{
  "model": "gemini-3.8-flash-tts",
  "input": [
    {
      "role": "user",
      "content": [
        {
          # パート1:明るく元気なツアーガイド
          "type": "text",
          "text": "皆さま、ジャングルクルーズへようこそ!右手に見えるのは樹齢三百年の大木です。",
          "speech_metadata": {
            "style": "cheerful and energetic safari tour guide projecting to a group"
          }
        },
        {
          # パート2:急に声を潜めて緊迫したささやき声へ
          "type": "text",
          "text": "<gasp> <short pause> しっ、静かに!茂みの奥で巨大なトラがこちらを見ています……絶対に動かないでください。",
          "speech_metadata": {
            "style": "urgent, tense whisper, terrified and hushed"
          }
        }
      ]
    }
  ],
  "generation_config": {
    "speech_config": { "voice": "Puck" }
  }
}
5. 2話者対話と「パイプ相づち(|うんうん|)」による掛け合い生成
従来の TTS で対話番組を作ろうとすると、話者Aの音声と話者Bの音声を別々に生成してタイムラインに並べるしかなく、「相手が話し終わるまで無言で待ち、0.5秒空けて話し始める」というロボットのような交互発話になりがちでした。
Gemini 3.8 TTS では、1回のリクエストで2人の話者を掛け合わせられるだけでなく、発言中のテキストにパイプ記号 |...| で1〜3語の短いリアクションを挟むだけで、もう一方の話者が「声を重ねて相づち(バックチャネル)を打つ」ことができます。
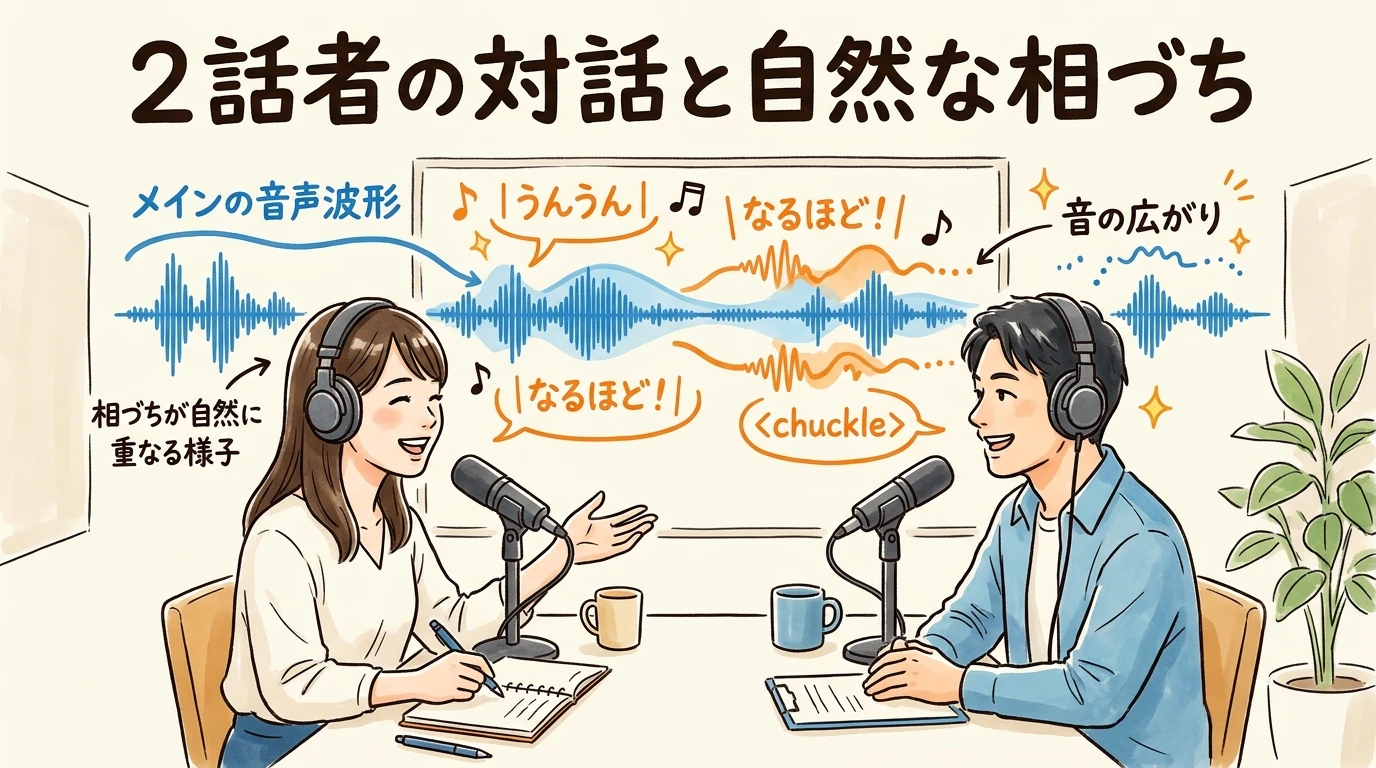
|うんうん| や |なるほど| を埋め込むと、話者B(Kenta)がそのタイミングで自然に相づちを重ねます。2話者対話+パイプ相づち(|ええっ| |なるほど|)
セリフの中に |うんうん| や |うそだろ| を挟むだけで、ターンを分割せずに相手話者が背景で自然に相づちを重ねます
ミサキ: ねえケンタ、昨日の深夜に美術館の警備員が見回りをしたときは |うんうん| あの名画はまだ壁に掛かっていたそうなの。 ケンタ: えっ、じゃあ赤外線アラームは一度も鳴らなかったってこと? |一度もよ| いったいどうやって外に持ち出したんだ? ミサキ: <chuckle> 夜中に忍び込んだんじゃなかったのよ。 |えっ、まさか| 朝の9時に清掃員の作業着を着て |うそだろ| 正面玄関から堂々と運び出したんだって!
パイプ記号 |...| の2つの使い方
長文の途中に1〜3語を挟む
話者Aの長いセリフの途中に |うんうん|、|なるほど|、|へえー!| などを挟むと、話者Aが話し続けたまま、背景で話者Bが小さく相づちを打ちます。ポッドキャストのリアリティが劇的に向上します。
ターンの先頭からパイプで囲む
話者Aのターンの末尾と、直後の話者Bのターン全体をパイプで囲む(例:A: せーの、|大成功!| → B: |大成功!|)と、2人が声を揃えて同時に発声します。番組のタイトルコールやサプライズ演出に最適です。
# 2話者対話+パイプ相づちの実装コード(Interactions API)
{
  "model": "gemini-3.8-flash-tts",
  "input": [
    {
      "role": "user",
      "content": [
        {
          "type": "text",
          "text": "こんにちは!今週のテック深掘りラジオへようこそ。今回は音声生成AIの進化について語ります。",
          "speech_metadata": {
            "speaker": "Misaki",
            "style": "bright, welcoming podcast host"
          }
        },
        {
          "type": "text",
          "text": "よろしくお願いします!いやあ、最近の音声モデルは本当にすごいですよね。",
          "speech_metadata": {
            "speaker": "Kenta",
            "style": "friendly, curious co-host"
          }
        },
        {
          "type": "text",
          # ↓ Misaki のセリフ中に |うんうん| |なるほど| を入れると Kenta の声で相づちが重なる!
          "text": "そうなんです。特に相づちが自然に重なるようになって |うんうん| まるで同じスタジオで向かい合って話しているみたいな |なるほど| 臨場感が出せるようになりました。<chuckle>",
          "speech_metadata": {
            "speaker": "Misaki",
            "style": "enthusiastic and expressive"
          }
        }
      ]
    }
  ],
  "generation_config": {
    "speech_config": {
      "speakers": [
        { "speaker": "Misaki", "voice": "Aoede" },
        { "speaker": "Kenta", "voice": "Puck" }
      ]
    }
  }
}
6. 固有名詞の読み方指定(IPA)と「やってはいけない」アンチパターン
専門用語やユニークな社名・キャラクター名などで読み方を厳密に指定したい場合は、日本語ならひらがな・カタカナ表記に置き換えるのが最も確実ですが、外国語や微妙なアクセント位置を指定したい場合はスラッシュ / ... / で囲んだ IPA(国際音声記号) を文中に直接記述できます。
# IPA(国際音声記号)による発音指定の例
"text": "本日のゲストは /nive/ さんです。東京の /niːhombäɕi/ スタジオからお届けします。"
長尺でも絶対に失敗しない!プロンプティング黄金ルール
| よくある失敗(アンチパターン) | なぜ起きるのか? | Gemini 3.8 流の解決策(ベストプラクティス) |
|---|---|---|
| 「落ち着いて読んで」という指示まで声に出して読まれた | text フィールドの中に演技指示(ト書き)を混ぜて書いているため。 | 演技指示はすべて speech_metadata.style に分離し、text には発声する言葉と公式 <tag> だけを書く。 |
| 感情を強く指定したら、別の人のような声に変わった | style に「若い女性の声で」など声質(第1層)に関わる指示まで書いているため。 | 声のアイデンティティは voice(または Voice Design)に任せ、style には感情・速度・トーンだけを書く。 |
| 1ターンのうちに無数の感情を書いたら演技が中途半端になった | 1つの style に「最初は怒って、次に泣いて、最後は笑う」と詰め込みすぎているため。 | content 配列を分割するマルチパートターンを使い、1ブロック=1つの明確なトーンにする。 |
7. 実践:3レイヤー・ディレクション&コード生成シミュレーター
ここまでの知識を使って、実際に3つのレイヤーを組み立ててみましょう。プリセットを選ぶと実際の生成音声を試聴でき、下のフォームを書き換えると Python / TypeScript / cURL のリクエストコードがリアルタイムに生成されます。
3層ディレクション&APIコード・シミュレーター
演出プリセットを選ぶか、下の「1. キャスト」「2. 演技スタイル」「3. セリフ&タグ」を自由に書き換えてみてください。実際の生成音声の聴き比べと、コピペしてすぐ動く API コード(Interactions API / Python / TypeScript / cURL)がリアルタイムに切り替わります。
style を空欄にすると、Gemini 3.8 TTS は句読点や文脈だけを頼りに自然な標準トーンで発話します。まずは空の style からテストするのが公式推奨の第一歩です。